
鄉親在活動現場連按兩次送出,真正需要的不是更多雲端產品,而是原單還在、等待有交代。今天把 Google AI 工具箱拆成模型入口、開發與編排、運算、資料四層,公開選擇與改選條件。讀者能跑一份決策表,分清文件能力、本機量測與尚待驗證的雲端表現。
A local service needs more than a collection of cloud products. This chapter separates model access, development tools, agent orchestration, compute, and persistent state. A small Python evaluator filters declared designs against changing requirements without inventing cloud measurements. It distinguishes Antigravity from the ADK runtime, examines the cost of warm instances, and connects Firestore transactions to service obligations. Readers leave with a repeatable decision process and explicit conditions for revisiting the chosen stack.
現場一句話:活動有尖峰也有空檔,怎麼兼顧鄉親等待與有限維運預算?
只准後端決定的規則:資料持久化與原子提交是門檻;缺少延遲紀錄,就保留待量測。
Google AI 用到/刻意不用:分開 AI Studio、Gemini API、Antigravity 與 ADK,不請模型替選型打印象分數。
五分鐘入口:python3 -m examples.day23.stack_matrix --eval。
這篇不能證明:本機決策核對不等於四套雲端方案已部署,也不是效能排行榜。
| 決策層 | LOCAL 的選擇與理由 | 替代方案 | 重新評估的條件 |
|---|---|---|---|
| 模型入口 | AI Studio 試提示,Developer API 接服務 | Vertex AI 模型路徑 | 組織身分、周界與資料政策改變 |
| 開發與編排 | Antigravity 協作;ADK 執行既有工具流程 | 其他 SDK 或框架 | 現有工具與評測契約無法承擔新需求 |
| 運算 | Cloud Run 承載容器與修訂版 | VM、GKE | 已有平台團隊或特殊執行需求 |
| 持久狀態 | Firestore 作雲端資料層;SQLite 驗本機契約 | Cloud SQL | 跨表查詢、報表與既有資料整合成主需求 |
模型可以建議下一步,但技術選型要為鄉親的每一次點擊與等待負責。 這張表的重點,是每個選擇都附上改選條件。
團隊參與的真實場域有兩類:一類是彰化縣政府官方 LINE「愛玩彰化」,承作「卦山大縱走」與彰化蔬食節等集章系統,需嚴守活動期程與公部門合約;另一類則是奇步與在地夥伴自營的彰化旅行+,串聯《爌肉之城》等在地文化,面對的是跨夥伴常態協同。維運這兩類服務時,我會先想手機前的人:假設鄉親走到八卦山步道旁,訊號不穩,送出後又按了一次;接手志工則剛輪班。這是設計情境,沒有新增店家地址或營業公告。
這裡同時有操作不確定、等待、交接與維運負擔。若只有一張「用了哪些 Google 服務」的圖,看不出哪個元件負責保住單號,也看不出誰需要處理失敗。工具越多,交接者要猜的地方可能越多。
這些在地作品背後,有白色方塊工作室、旅庫彰化等夥伴一起整理地方脈絡;到了軟體這端,我也得整理責任。Gemini 理解問句、工具讀資料、資料庫保存承諾,並不是同一件事。
昨天的停止閘門已說明:控制狀態與原單要在能共同提交的邊界內處理。今天換資料庫或執行平台,這條要求仍要留下。[1] 我用架構決策紀錄(ADR)把「需求、選擇、代價、何時重看」寫在一起,比替產品打星等更方便接手。
兩秒也要說清楚。LINE 將伺服器兩秒內未回應記為 request_timeout,這是 Webhook HTTP 回應,不是模型完成整項服務的期限。官方建議非同步處理;若後續工作要跨行程存活,還需可靠排程或持久佇列,不能只在回應後開一個背景函式就算交付。[2]
本篇新增 examples/day23/stack_matrix.py,只用標準函式庫。本篇程式位於 examples/day23/,從專案根目錄執行。預設指令不呼叫模型、不建雲端資源;輸出目錄必須是新的。
python3 -m unittest examples.day23.test_stack_matrix -v
python3 -m examples.day23.stack_matrix --eval \
  --out out/day23/community
python3 -m examples.day23.stack_matrix --eval --profile governed \
  --out out/day23/governed
stack_options.json 放四份明示設計:run-zero、run-warm、vertex-run、sql-run。它們是方案,不是四台已量過的伺服器。community 先看持久狀態與原子變更;governed 再要求模型服務周界(像 VPC Service Controls 這類限制資料進出的邊界);reporting 則增加關聯式查詢需求。
| 方案識別 | 模型/資料層 | Cloud Run 最小實例 | community |
governed |
|---|---|---|---|---|
run-zero |
Developer API/Firestore | 0 | 保留 | 排除 |
run-warm |
Developer API/Firestore | 1 | 保留 | 排除 |
vertex-run |
Vertex AI/Firestore | 1 | 保留 | 保留 |
sql-run |
Developer API/Cloud SQL | 0 | 保留 | 排除 |
這是依宣告需求產生的結果。周界欄表示設計需要支援該能力,真正模型、區域、IAM 與周界設定仍須另驗。增加 --require-scale-zero,保留一個暖實例的方案就被排除;同時要求周界時,這四份設定甚至可能沒有任何候選。正確做法是修改需求或另提方案,而非硬選總分最高者。
判斷條件直接寫在 assess(),不是先把 Google 選項排第一再找理由。下列是同函式的核心節錄;輸入格式檢查與完整報告欄位在隨附程式中。needs 是需求,option 是方案宣告,兩者都還不是雲端測試結果:
reasons = []
if option['orchestrator'] != 'adk':
    reasons.append('RUNTIME_CHANGE_REQUIRES_REGRESSION')
if not option['durable_state'] or not option['atomic_changes']:
    reasons.append('STATE_CONTRACT_UNSUPPORTED')
for name in ('model_perimeter', 'relational_joins'):
    if needs[name] and not option[name]:
        reasons.append('REQUIREMENT_UNMET:' + name)
scale_zero = option['hosting'] == 'cloud_run' and option['min_instances'] == 0
if require_scale_zero and not scale_zero:
    reasons.append('SCALE_ZERO_REQUIREMENT_UNMET')
讀者可以改用 --profile reporting,觀察為什麼留下 sql-run。這個練習不是宣稱 Cloud SQL 跑得比較快,而是需求從依單號讀取,變成需要關聯式查詢支援。先保留理由,才有辦法在下一次需求會議說明為什麼改選。
輸出保留 CANDIDATE 與 EXCLUDED,不使用「上線通過」。四份方案的 latency_status 都是 NEEDS_MEASUREMENT,deployment_status 都是 NOT_VERIFIED。以下節錄程式中的門檻核對,完整數值檢查同時拒絕負數、布林值與非有限值:
def latency_check(value: float | None, limit_ms: float = 2000) -> str:
    """Threshold arithmetic only. A PASS is not proof of measurement origin."""
    number(limit_ms, 'limit_ms', positive=True)
    if value is None:
        return 'NEEDS_MEASUREMENT'
    return 'PASS' if number(value, 'latency_ms') <= limit_ms else 'FAIL'
試著把未知當零,所有方案都會看起來很快;保留 None,才知道下一步缺的是量測。這不是刻意保守,而是避免選型表替沒有發生的實驗簽名。
本篇另附 --probe,會在新 Python 行程匯入這份程式,保存逐次耗時與可取得的峰值記憶體。examples/day23/evidence/probe_linux.json 記錄了五次執行,中位耗時為 918.638 毫秒(本機 macOS/Python 3.14.2 實測中位數約 162.7 毫秒);量到的是建立行程、匯入與離開的總時間,與 Cloud Run 冷啟動是兩個範圍。
python3 -m examples.day23.stack_matrix --probe --runs 5 \
  --out out/day23/local-probe
| 量測項目 | 本次狀態 | 之後要固定的條件 |
|---|---|---|
| 本機新行程匯入、峰值記憶體 | 留有 probe.json;僅限本機 |
Python、作業系統、程式雜湊 |
| 相依套件/容器映像大小 | 四方案尚未建置量測 | 套件鎖檔、映像 digest、CPU 架構 |
| 雲端冷啟動與 Webhook 回應 | 未量測,維持 null |
區域、資源、暖機與冷啟分組 |
| 模型耗時與網路往返 | 未量測,維持 null |
模型、輸入、重試與觀測起訖 |
一般電腦上的匯入測試省去很多雲端環節,作業系統快取也未必清空。這張表先幫我分清楚,每一把尺量的到底是什麼,而不是拿同一個毫秒欄位比較完全不同的東西。
AI Studio 是試模型與提示的介面;LOCAL 程式呼叫的是 Gemini Developer API。官方提供 System Instructions、執行設定與取得程式碼的入口。[3] 我可以先拿公開或合成問句觀察模型,再把模型識別、工具宣告與設定保存到程式,讓離開瀏覽器後仍知道當時測了什麼。
這不是「小案子用簡單工具、大公司才用安全工具」。我會先問資料能否送往這個端點、誰管理憑證、需要哪些存取與稽核能力。Secret Manager 管的是金鑰取用,不會替資料內容取得同意,也不會改寫模型服務的資料條款。
有集中身分管理、指定區域或 VPC Service Controls 要求時,我會評估 Vertex AI 路徑。支援情況要按模型及功能查表,不能把自架模型的專屬端點能力直接套在所有 Gemini 呼叫。[4] 即使是地方協會,只要合作案有這些要求,也應把治理放在方便之前。
| 需求問題 | 先保留既有路徑 | 進入重新選型 |
|---|---|---|
| 提示與工具契約仍在調整 | AI Studio 試驗,Developer API 接程式 | 需要額外組織控制時評估 Vertex AI |
| 需要哪種身分治理 | 管好 API Key、秘密版本與後端授權 | 使用服務身分與 ADC,逐項驗 IAM |
| 遷移後模型是否同等可用 | 鎖定既有模型與端點 | 查區域、配額、工具與思考設定支援 |
| 哪個比較省 | 尚未做同條件比較 | 用相同題目、版本與實際費率計算 |
官方統一的 Google Gen AI SDK 支援兩條模型路徑,降低程式遷移負擔;它沒有替我承諾兩端價格、配額與可用功能相同。[4] 本篇沿用系列的 Vertex AI 稱呼;本次查閱的官方遷移頁已使用 Gemini Enterprise Agent Platform 名稱,讀文件時要對回實際端點。
這裡先把兩種 Agent 分開。Antigravity 在本專案的主要角色,是開發協作:讀專案、提出修改、協助執行測試與查看差異。LOCAL 接到 LINE 問句之後的服務編排,則是 Google ADK。官方 Antigravity 現在另有 SDK,這不代表本專案已把執行核心換成它。[5]
既有 examples/day14/adk_router.py 實際使用 LlmAgent、Runner、ToolContext;它把工具要求、Python 執行與回應分開紀錄,也限制模型呼叫次數。[6] 這是我保留 ADK 的具體理由:既有事件與契約可以延續,而不是只因為它與 Gemini 同屬 Google。
我希望 Antigravity 幫忙的,是把一句需求變成可審閱的變更。例如「更換模型端點」不能只改一個字串;還要檢查設定、驗證案例、成本來源與錯誤回覆。開發 Agent 產生的計畫是工作起點,真正採用的仍是差異、程式與執行結果。
選型表因此固定本輪 orchestrator=adk。改成其他執行核心,會得到 RUNTIME_CHANGE_REQUIRES_REGRESSION,不是宣判那個產品不好,而是承認本案還沒做替換驗收。Antigravity 再好用,也補不了執行流程裡還沒驗證過的部分。
LangChain、CrewAI、AutoGen 沒有參加本次效能對照,我不把它們統稱為看不見內部行為的框架。以 LangChain 生態的 LangGraph 為例,官方就有 checkpoint 持久化設計。[7] 真正要比較的是重試能否設限、工具執行能否核對、狀態放哪裡,以及換框架後原單還能不能查回。
ADK 也不會自動替所有狀態做正確持久化。既有程式使用短生命週期 Session,是本案的明示選擇;業務單據另有保存責任。把兩者混為「框架有記憶,所以單據不會丟」,仍會回到 Day 22 剛處理完的問題。[6]
Cloud Run 適合本案的理由,是保留既有容器服務而把部分基礎設施維護交給平台。預設無流量可縮到零;設定最小實例能保留暖實例,代價是閒置成本。[8] 所以「一定縮到零」是成本上的偏好,不應該凌駕在鄉親的等待之上。
暖實例可能減少啟動等待,但沒有因此得到兩秒回應保證。冷啟、驗簽、排程、模型與工具都各有耗時。我的選型順序是先把 Webhook 接收和後續工作分開,再量冷暖請求,最後決定是否值得保留容量;本篇尚未完成這條非同步雲端接線。[2][8]
縮到零也不等於專案帳單歸零。映像儲存、建置、資料庫、網路與其他服務要分別看費率;Cloud Run 官方價格頁也把 Cloud Build、Artifact Registry 費用另列。[9] 我需要的是完整費用範圍,而不是截取一個資源當月剛好免費的畫面。
若團隊已有穩定 VM、部署流程與維運人力,沿用可能比遷移更合理;需要 Kubernetes 的治理與工作負載能力時,GKE 也值得評估。本案暫不加入那些操作面,是取捨,不是用未測的每月費用替替代方案判輸。
資料層則先看存取方式。Firebase 是產品組合,Cloud Firestore 是其中的資料庫,不等於把整套 Firebase 功能全部採用。我目前需要依單號查狀態、做條件式更新;若跨表報表與既有關聯資料成主需求,就回頭比較 Cloud SQL。Cloud Run 官方有連接 Cloud SQL 與連線池指引,Webhook 事件流不是排除關聯式資料庫的理由。[10]
Firestore 預設讀取具強一致性,交易提供可序列化隔離。[11] claim_version 表示應用層允許哪次認領,不是替資料庫補一個不存在的「弱一致性缺洞」。只把讀取與寫入分成兩次呼叫,仍可能遇到競爭;該驗的是交易範圍和衝突處理。
更重要的是 Firestore 交易函式可能重跑。[12] 模型請求與 LINE 推播要留在交易外;交易內核對版本並保存通知意圖,再由派送端處理。SQLite 能驗這份邏輯,卻不能代替 Firestore 的並行整合測試。Day 22 的停止狀態與 outbox,目前仍以本機契約為證。
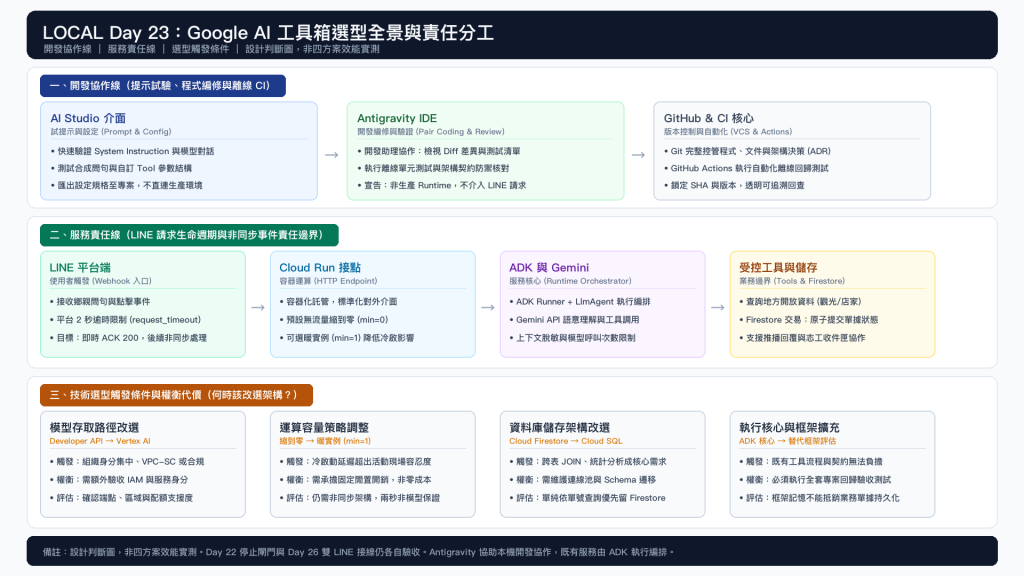
我把選型全景拆成兩條線,畫架構圖時也保留這個分工:
| 路徑 | 元件順序 | 接手時看哪份證據 |
|---|---|---|
| 開發線 | AI Studio 試提示 → Antigravity 協作 → GitHub 差異與 CI | 提示、工具版本與測試紀錄 |
| 服務線 | LINE → Cloud Run 接點 → ADK/Gemini → 受控工具 → 持久狀態 → 固定回覆 | 同回合事件、單號與資料變化 |
| 治理線 | 部署身分 → 執行身分 → 秘密與資源授權 | IAM 規劃及後續允許/拒絕驗收 |
服務線是目標責任圖,不把每個箭頭都畫成已接線。Day 21 的直接 SDK 回應與重建下游事件仍分開;Day 22 的雙 LINE 視窗仍待 Day 26。本篇的決策表不會替它們補出不存在的部署結果。
| 新條件 | 決策動作 | 要付出的代價 |
|---|---|---|
| 冷請求影響接收 | 比較暖實例與可靠非同步接收 | 閒置費、佇列及重試管理 |
| 模型資料必須受服務周界約束 | 評估 Vertex AI 對應功能 | IAM、區域與周界驗收 |
| 查詢變成大量跨表報表 | 比較 Cloud SQL 與資料建模 | 連線池、遷移與回歸 |
| 新增多工具工作流 | 版本化 ADK 事件與執行規則 | 更多案例、延遲與費用 |
這份紀錄將需求與程式、方案設定雜湊一起輸出。文件能支持「平台提供這項能力」,只有部署紀錄與量測才能支持「這套設定在本案做到」。兩者分欄,往後才知道是需求變了,還是原先理解錯了。
本篇附檔完成二十六項離線自測,包括未知值不補零、條件改變就重選、布林值不當數字,以及本機探針不升格為雲端量測。Day 23 工程基線 e59bc77;專用 Actions Run 37537427197 通過二十六項測試,並完成三種設定檔與本機探針執行,這些測試不沿用 Day 22 的 Run 作證。
下一篇是 Day 24|改了一行,20 題還過嗎?Google AI 實測牆與 A/B 成本量測。九題真實路由、二十題契約回歸與六列 A/B 各有分母,原始回應、工具參數、思考用量與費率也分開保存。改模型或設定之前,先核對它是否仍是同一個比較。
我希望讀者帶走的不是一張永遠正確的工具清單,而是一個遇到新限制仍能做決定的方法。鄉親不用知道選了哪套 SDK;他只需要少等一次、少重填一次,接手的人也找得到原因。
本篇新增 stack_matrix.py、stack_options.json、test_stack_matrix.py,離線選型與本機探針分開執行。官方資料核對日:2026-10-06。
[1] Day 22:停止閘門與驗收邊界。
[2] LINE:Webhook 逾時與非同步處理建議。
[3] AI Studio 入門與執行設定。
[4] 兩條 Gemini API 路徑與Google Cloud 模型安全控制。
[5] Antigravity 產品介面與 SDK。
[6] ADK 執行介面與LOCAL 既有編排程式。
[7] LangGraph 持久化。
[8] Cloud Run:自動縮放與最小實例。
[9] Cloud Run 計費範圍。
[10] Cloud Run 連接 Cloud SQL。
[11] Firestore:讀取一致性與交易隔離。
[12] Firestore 交易重跑與限制。


 iThome鐵人賽
 看影片追技術